构建主题深度以提高生成式引用概率
在复杂领域建立权威的内容覆盖,向算法检索评估器和生成式引擎传递全面的专业能力信号。
生成式引擎倾向于引用展现出详尽主题深度的内容源,因为检索增强生成(RAG)算法优先青睐语义密集、表意权威且能无歧义解决多跳查询的段落。多项研究表明,AI引用在很大程度上呈现“局部主题化”特征——近79%的被引域名仅出现在单一主题下。这意味着对实体属性、边缘案例以及对比情境的深度覆盖,远比宽泛而浅薄的全局域名权重更能稳健地推动内容被收录与引用。
核心要点
- RAG系统通常将文档切分为大约200至1,000个Token的段落块,将其向量化后检索Top-K候选——因此,你的网页是在段落级别而非整页级别与他人竞争。
- 一项针对六大主题领域的研究发现,AI回答引用的域名中有78.8%仅出现在单一主题中,证实了引用是凭借局部主题深度针对单个提问逐一斩获的。
- 信息增益(衡量页面相对于已有候选内容贡献了多少全新知识)发挥着动态过滤机制的作用,将优质被引源与无人问津的陈词滥调区分开来。
- 引用的衰减速度极快:中位数页面在达到峰值后仅11天就会失去一半的引用份额,因此持续保持新鲜度并进行迭代更新至关重要。
- 割裂且重叠的子主题集群会导致关键词自相蚕食,使AI引用分散在多个重复URL之间;每个URL必须拥有且仅拥有一个清晰的独立意图。
生成式搜索时代主题权威的演变
主题权威已从单纯的“关键词覆盖”概念,转变为衡量一个域名能否完整、一致地解决某一特定学科领域的结构化指标。在生成式时代,权威性被理解为一种“内容形态”:定义稳定、不发生漂移的互联实体集群,比起大量松散孤立的文章更能确立深厚的专业公信力。
从关键词密度到语义完整性
主题深度指的是单篇内容以及整个主题集群内部信息的详实度与丰富度——这也是区分浮于表面的平庸内容与全面权威枢纽的分水岭。现代检索评估机制奖励对子主题、研究视角、概念定义和使用场景的穷尽式覆盖,而非关键词的重复堆砌。聚焦于少数几个具备深厚专长的领域,而非铺摊子做广而浅的文章集合,才能在大语言模型眼中树立起真正的权威实体形象。
RAG系统如何切分、向量化与重排文档段落
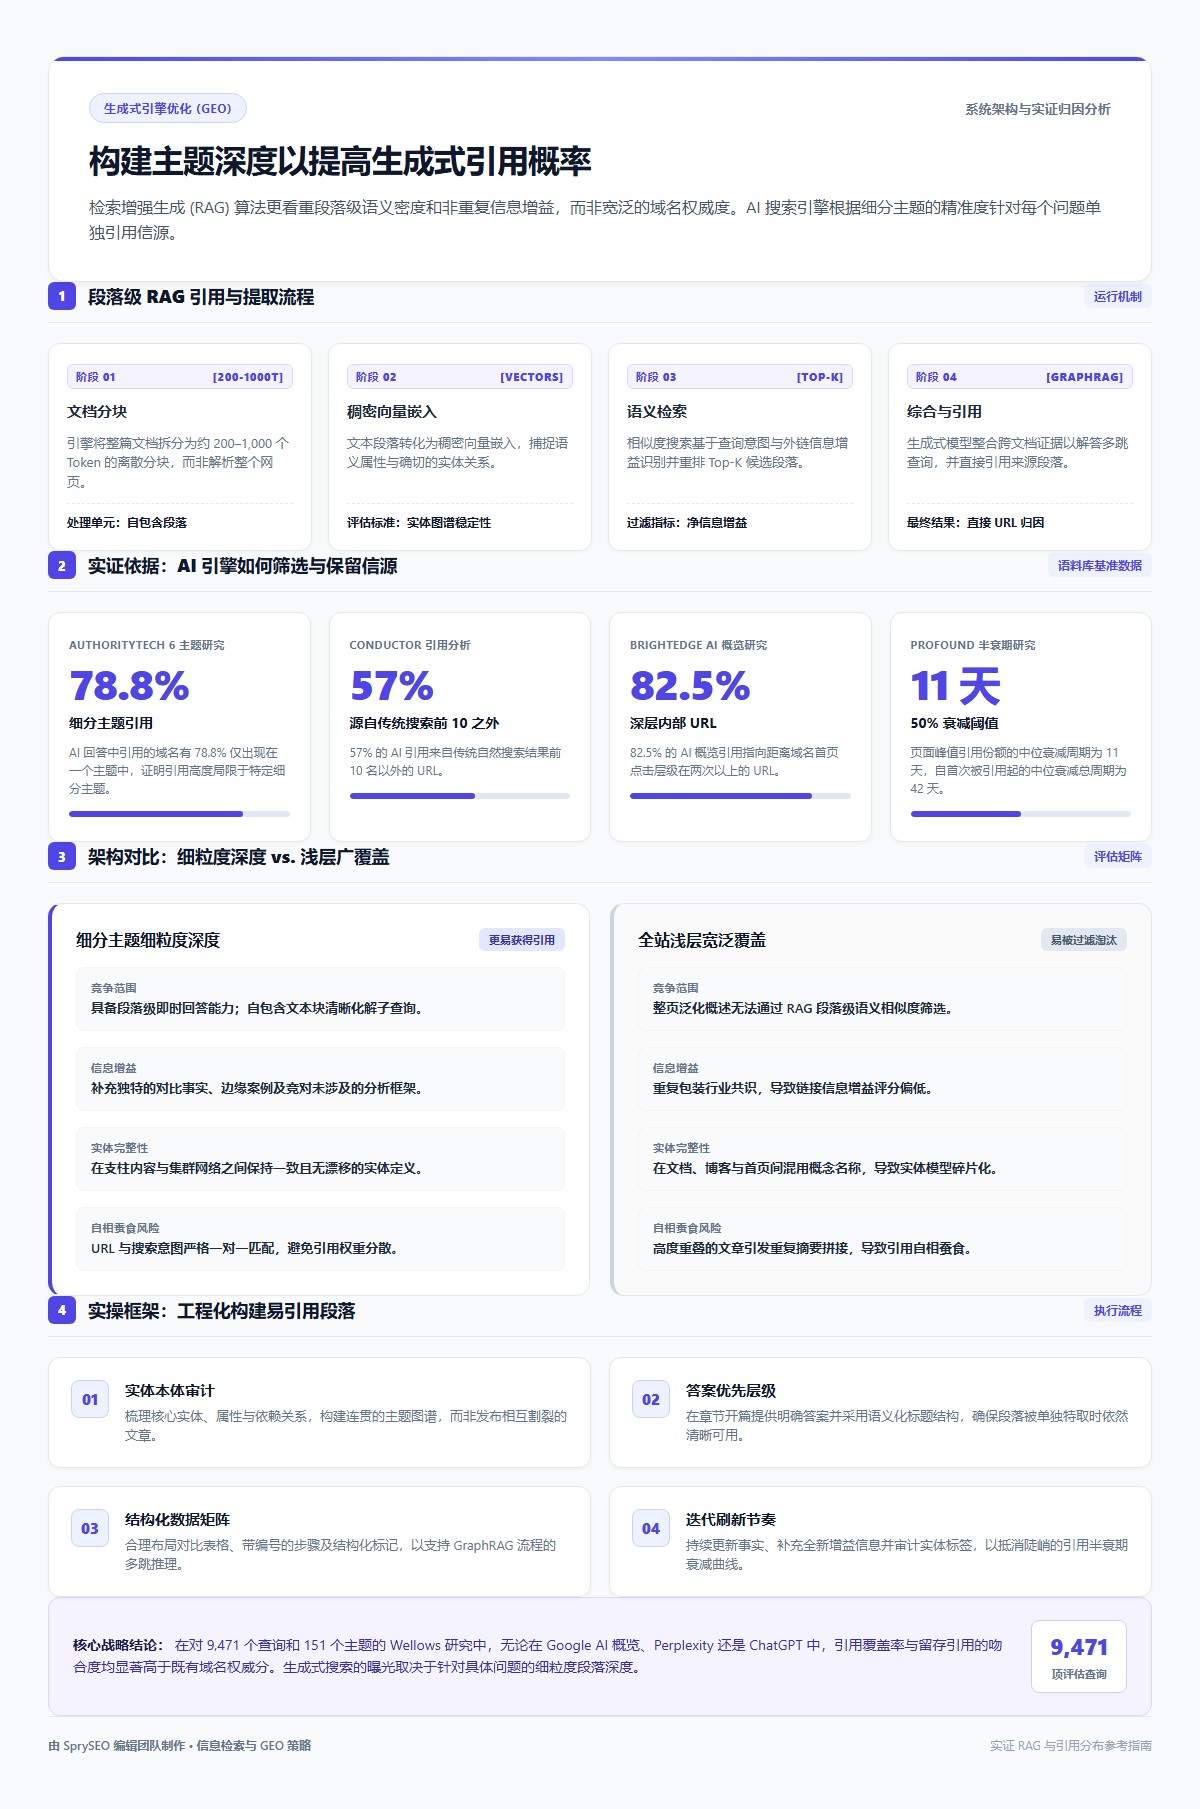
透彻理解底层的检索逻辑,有助于阐明为何深度如此关键。RAG系统通常将文档拆解为200至1,000个Token的片段,生成密集向量嵌入,执行语义相似度搜索以检索最相关的Top-K候选切片,随后对候选块进行重排,并构建Prompt交由大语言模型进行综合与引用。
至关重要的一点在于:模型并不通读整张网页,它接触到的是文本切片或段落。针对每一个子查询,系统都会通过分块、嵌入和密集检索来处理相关内容。你的网页是在段落层面而非文档层面参与角逐。这意味着每一个独立段落都必须能够自成一体,作为针对特定问题的精确、自闭环回答。
主题深度与主题广度:理解引用门槛
主题深度与技术结构构成了AI搜索系统中驱动内容引用的两大核心抓手,这就要求内容必须针对各个子主题提供详尽、扎实的知识储备,而非在多个主题间蜻蜓点水。
为何浅尝辄止的多主题覆盖无法通过生成式过滤
当内容分散在许多关联度较低的主题上时,单个段落往往缺乏足够的密度和细节来赢得段落级的相关性打分。从编辑视角来看,缺乏细颗粒度深度的横向广度在GEO时代反受其害:它不仅会造成索引臃肿,还会在RAG段落检索的相关性过滤中被直接淘汰。提供泛化建议的网页,必然会败给那些包含颗粒化技术拆解、自包含段落解答以及精准实体定义的专业页面。
局部主题权威:为何垂直深度完胜全站权重
实证数据为深度的重要性提供了强力支撑。针对六个测试领域的专项研究表明,AI回答引用的域名中有78.8%仅出现在单一主题中,这表明AI引用是高度局部化的,而非单纯依赖全站全局权重。同样,一项跨越9,471个提问与151个主题的研究显示,在Google AI Overviews、AI Mode、Perplexity以及ChatGPT中,引用覆盖率与留出测试集引用的相关度均显著高于系统内部存储的既有权威分值。
这彻底重构了优化策略:域名权重或许能在传统搜索中换取曝光广度,但生成式引用完全是针对具体提问单点击破的。拥有主题深度,意味着你的覆盖面足够扎实,展现出真正信息源的质感,而非薄薄的一页推广单。
AI搜索引用与排名的实证信号
| 研究 / 指标 | 核心发现 / 分布特点 |
|---|---|
| Wellows 9,471问题研究 | 在五大引擎中的四家(AI Overviews、AI Mode、Perplexity、ChatGPT)上,引用覆盖率与留出引用的相关性均高于既有权威评分 |
| AuthorityTech 局部主题分布 | AI回答引用的域名中,有78.8%仅出现在六个评估主题中的某一个主题下 |
| Profound 引用半衰期分析 | 中位数页面在达到峰值后11天内失去50%的引用份额;从首次被引至跌落峰值份额50%的中位周期为42天 |
| Conductor 2026年9月引用分析 | 43%的AI引用来自自然搜索前10名的URL;57%的引用源自自然排名前10名以外的页面 |
| BrightEdge AI Overview 深度分析 | 82.5%的AI Overview引用指向距离主页点击距离达到或超过两层的深层URL |
生成式引擎信息归属的核心驱动力
密集主题集群中的信息增益与独特性
Google拥有名为“链接信息增益的上下文估计”(Contextual Estimation Of Link Information Gain)及“信息增益评分”(information gain score)的专利,该技术专门评估某篇文档相对于用户已浏览或已检索的候选页面,贡献了多少真正具有新增价值的内容。信息增益绝非单纯停留在专利层面的理论概念,它充当着极其活跃的筛选机制,通过衡量候选文档是否能向检索池输入全新的、非重复的知识,将值得引用的权威源与毫无新意的总结区隔开来。
在实践中,这意味着每个段落都应当补充竞品内容中尚未提及的独立事实、对比分析、边缘场景或逻辑框架。单纯换汤不换药地整合大众共识,只能带来极低的信息增益,几乎无法获得引用机会。
通过连贯实体语境促进多跳推理
许多AI回答需要跨越多个概念串联论据。将知识图谱与大语言模型相结合的技术(GraphRAG)能够将抽取的知识组织成结构化图谱,通过子图检索与路径推理,在跨文档关联与多跳推理任务上展现出远超扁平RAG系统的表现。借助显式图谱化组织,GraphRAG在处理复杂查询时展示了更出色的可控性与推理能力。
若内容能够明确标注实体并厘清它们之间的关联——如属性、依赖关系及横向比较——就更易于被检索系统顺着推理路径进行遍历,并将你的段落提取为逻辑连接的关键论据。
结构化数据与清晰论断赋能段落直接提取
通过自闭环的独立章节、结构明确的对比表格、带编号的先后步骤、Schema结构化标记以及一致的实体命名来组织内容,能够让AI回答引擎更轻松地完成提取、概括与引用。当一个段落脱离上下文单独引用仍能表意明确时,它就具备了随时被抽取的就绪状态。表格厘清了利弊权衡,数字列表锁定了逻辑先后——这两种形式都与引擎组织答案的方式高度契合。
打造穷尽式主题深度的系统化框架
对标领域实体本体审计现有内容覆盖
首先将你的学科领域拆解为实体本体(Entity Ontology)——即定义该领域的关键实体、核心属性与彼此关联。主题权威是一种结构形态,而非虚浮的分值:搜索引擎和大语言模型在评估时,关注的是你网页上的实体能否交织成一张逻辑严密的主题图谱。一个拥有数百篇围绕名义主题散乱展开的文章网站,其权威度往往极其低下;而一个结构紧密、术语定义在各个页面间高度一致的集群,则具备强大的公信力。
识别知识盲区与未解决的用户子查询
将梳理出的本体同用户提问与意图阶段进行匹配映射。借助提问挖掘与竞品大纲对比,确保集群覆盖的完整性,进而筛查出尚未得到解答的子话题、专业定义、对比视角及故障排查盲区。每一个未填补的缺口,都意味着一段原本可以赢得引用的潜在优质段落,目前正被竞争对手占据着。
构建分层支柱-集群网络并规避关键词蚕食
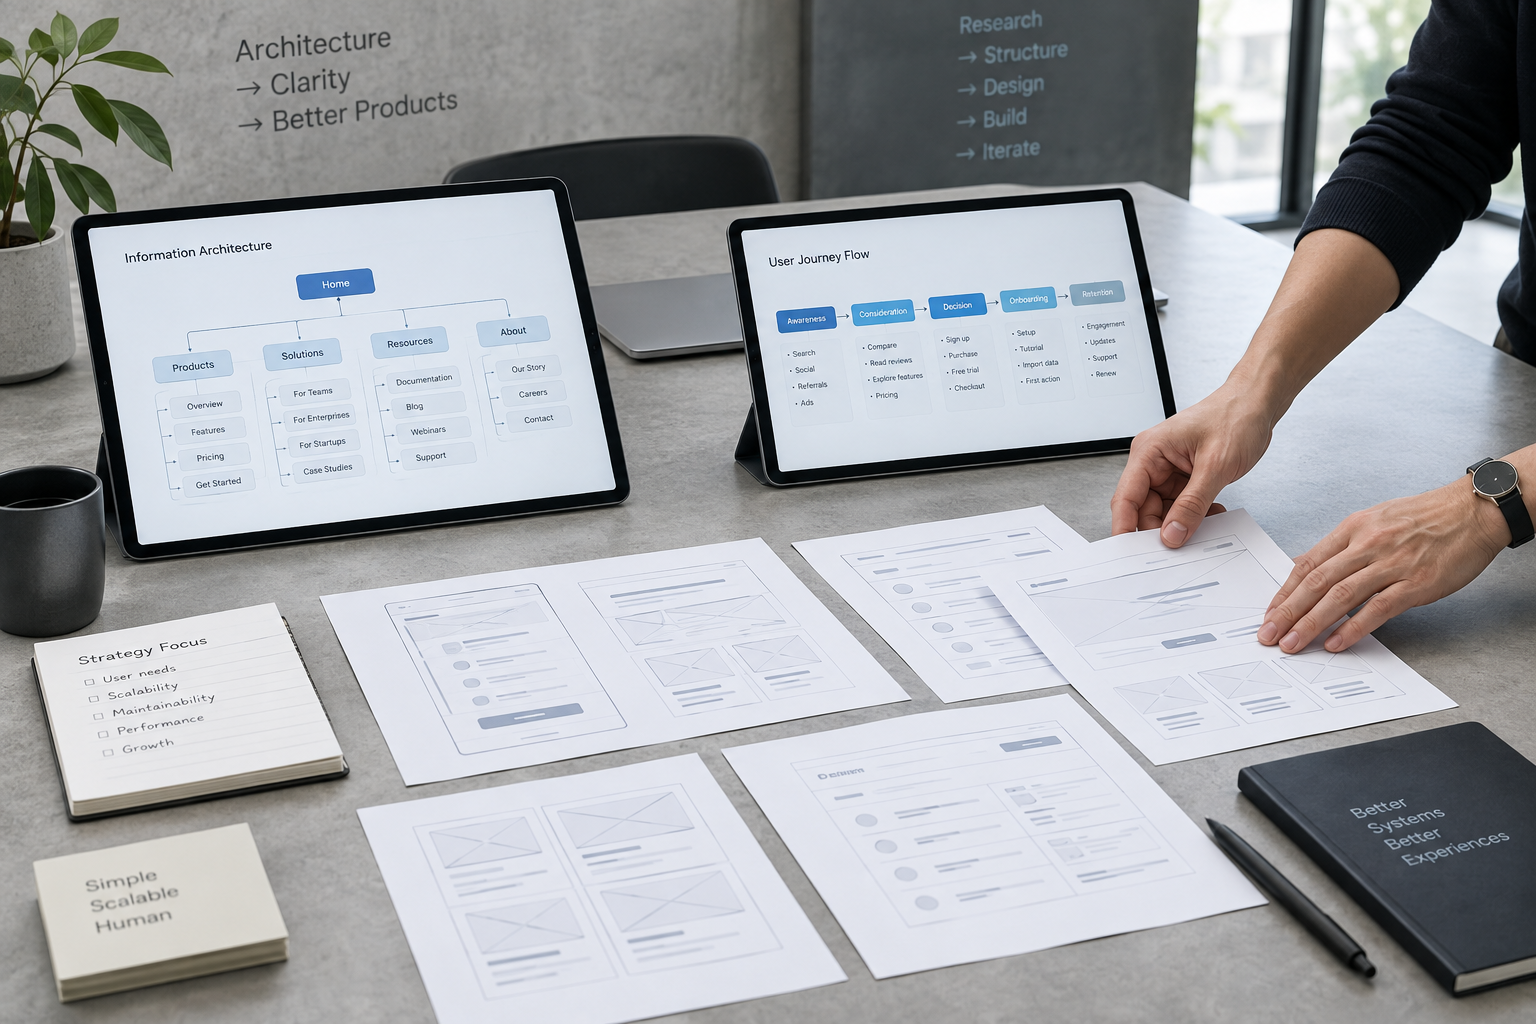
采用“支柱-集群”(Pillar and Cluster)的层次化形式规划内容:由一篇综合性的支柱页面覆盖核心大类,并下挂链接至具体的集群子文章,每篇子文章严格对应单一搜索意图。这正是策略设计与风险防控交汇的关键点。在多篇重叠文章之间发生关键词蚕食会让AI模型感到困惑,甚至导致引用冲突或份额割裂,因为大语言模型会在同一站点的互斥网页中提取碎片进行拼凑。
要化解这种执行层面的矛盾,必须为每个URL赋予唯一的重点意图,确保意图之间绝不出现重叠交叉。向更细微的子主题延展固然可贵,但前提是每个页面都有明确的区隔度;否则,覆盖面拓展带来的收益将被重复URL带来的引用分散消耗殆尽。
提升段落提取概率的内容架构策略
答案前置排版与语义标题层级
每个小节的开头应直接给出自成一体的核心答案,随后再展开证据进行支撑。由于每个段落都需要保证在单列引用时清晰可读,因此在写作时应当适时停下来思考:这一段如果被脱敏剥离出来,能否独当一面?与此同时,层级严谨的语义标题有助于AI引擎进行精准的内容切片,并将其高效匹配给各个细分子查询。
权威对比矩阵与结构化数据编码
对比表格与Schema结构化标记能够以极其干净利落的格式对关联信息进行编码,方便引擎提取。目的明确的表格把关键取舍梳理得一目了然,而结构化数据与统一定义的实体名称则进一步强化了促成多跳推理与源头归属所需的逻辑链条。
消除冲突论断与不一致的实体标签
整站范围内出现的实体表述混乱(例如在首页、文档库和博客文章中对同一事物使用不同称谓)会造成互斥的实体表征,进而侵蚀AI的引用置信度。如果首页、文档和博客对同一核心概念各有各的叫法,实际上相当于向模型输入了三个彼此割裂的实体。在每个页面上强制推行标准化的定义与命名,才能向大语言模型呈现一个连贯、可信的权威源。
衡量生成式曝光并应对引用衰减
追踪AI引擎提及与归属权重
评估效果时应当关注综合信号矩阵而非单一点状数值:包括在各大平台中的引用频次、引用份额、来源归属清晰度以及评价偏向等。请注意,被AI引用并不以传统自然排名名列前茅为前提——统计数据显示,有57%的AI引用来自于自然搜索前10名之外的页面,且有82.5%的AI Overview引用指向距离首页点击深度超过两层的内容。深层内页同样完全有能力赢得引用席位。
迭代刷新内容以对抗引用半衰期曲线
引用的有效生命周期非常短暂。针对AI引用的统计研究发现,中位数页面在达到引用峰值后仅11天就会失去半数的引用份额,而从初次获得引用到峰值份额折半的中位时间跨度为42天。这种典型的“半衰期”规律要求我们必须建立常态化的内容刷新机制:持续更新事实数据、增补全新的增益信息、加固实体定义的一致性,从而保住入选席位,绝不能将内容发布视为一劳永逸的单次操作。
深度与权重之争的定论
业界的核心争议——反向链接与域名权重是否依然凌驾于主题深度之上——随着局部主题深度的实证数据逐步公开而已现清晰趋势。在五大生成式引擎中有四家表现为引用覆盖率超越既有权威评分,且近79%的被引域名属于局部垂直领域,深层、一致、易于抽取的针对性内容无疑已成为斩获生成式搜索曝光更为稳健的抓手。落地实操的准则非常纯粹:扎扎实实打磨实体级内容深度,保持结构的高效连贯,并执行常态化的迭代更新。
关于作者
本文由SprySEO编辑团队倾力创作。SprySEO是一家集网站分析、主题规划、AI文章生成、SEO及GEO深度质检与定时发布于一体的SEO与GEO内容自动化平台,致力于帮助各类品牌在传统搜索引擎与前沿AI回答中建立卓越的可见度。我们的编辑视角深深扎根于信息检索底层原理与可规模化落地的多站点内容运营实践之中。
免责声明
本文内容仅供信息参考,基于文中所引用的生成式搜索与RAG检索技术最新研究动态撰写而成。AI回答引擎的技术架构、排名信号及引用逻辑迭代极为频繁;实际成效会因域名资质、所处行业与具体落地策略的差异而有所不同。读者在做出重大运营战略决策前,务必结合自身的一手业务数据与各平台官方发布的最新文档进行验证核对。
常见问题